AI AGENT & RAG ENGINEERING · HANGZHOU

Des agents IA
pour vos métiers.

Une expérience concrète du développement RAG et des agents IA, avec une équipe de 20 personnes en développement full-stack, algorithmes, données et qualité.

Échanges écrits en japonais / Réunions en anglais

20Personnes mobilisables durablement
4Expertises complémentaires
2Projet complet / Engagement à temps plein

01 / AGENT ENGINEERING

Du cœur technique
à vos systèmes métier.

Les membres de l’équipe ont développé la logique centrale de systèmes RAG et d’agents IA, ainsi que des outils LLM de création et de révision de sujets d’examen.

EXPÉRIENCE PRATIQUE DES MEMBRES
01

Développement RAG et agents IA

Organiser recherche, raisonnement, appels d’outils et exécution en plusieurs étapes autour des tâches métier. Connecter documents, API et systèmes existants, avec validation humaine des actions importantes et journal d’exécution.
02

Connaissances et traçabilité

Les membres de l’équipe ont travaillé sur des bases de connaissances, des graphes et des outils de création de sujets. Nous pouvons structurer documents, métadonnées et citations pour retrouver les preuves originales.

03

Intégration et exploitation de modèles

Connecter plusieurs fournisseurs via l’authentification, le routage, l’isolation des clients et le suivi des usages. Adapter modèles et contexte à la tâche, en évaluant qualité, délai et coût.

RAG / INGÉNIERIE DES CONNAISSANCES

Des documents dispersés.
Des réponses traçables.

La génération augmentée par la recherche (RAG) retrouve les preuves utiles dans vos informations avant que le modèle ne rédige une réponse. Nous intégrons gouvernance documentaire, contrôle d’accès et évaluation pour un système vérifiable et actualisable.

  1. 01Sources métier
  2. 02Analyser et indexer
  3. 03Chercher et reclasser
  4. 04Répondre et citer
01

Connecter et organiser les sources

Définir les PDF, documents Word, tableaux, pages Web ou données métier concernés. Préciser catégories, responsables et mises à jour, ainsi que les sources autorisées pour les réponses.

02

Analyser et structurer les documents

Traiter OCR, mise en page, titres et tableaux. Découper selon le sens et la structure métier tout en conservant fichier, page, section et version.

03

Combiner les méthodes de recherche

Associer recherche par mots-clés et vectorielle, avec reformulation, filtres de métadonnées et reclassement si nécessaire. Tester des questions représentatives pour identifier les preuves manquantes ou hors sujet.

04

Répondre à partir des preuves

Composer les réponses avec des citations qui localisent la source. Définir le traitement des preuves insuffisantes, documents périmés et conflits de versions : clarification ou validation humaine.

05

Gérer accès et mises à jour

Filtrer par utilisateur, service ou client. Séparer les droits de dépôt, validation et publication, et définir les ajouts, modifications, retraits et synchronisations d’index.

06

Évaluer et améliorer

Créer un jeu de questions, réponses de référence et preuves. Évaluer recherche, citations, qualité, latence et coûts, puis améliorer à partir des retours et échecs.

Exemple illustratif de questions-réponses

Qui valide cet achat et quels documents faut-il fournir ?

Retrouver le processus selon le type et le montant d’achat, avec les références de la règle applicable. Si le montant manque ou si plusieurs versions existent, clarifier ces points avant de conseiller.

Références fictives

Politique d’achat · Validation · Section 4

Guide de demande d’achat · Documents · Section 2

Comprendre la preuve, la version applicable et l’action suivante.

Livrables possibles

  • Collecte et analyse des sources
  • Index de connaissances et API de recherche / réponse
  • Citations et gestion des accès
  • Jeu d’évaluation, échecs et améliorations
  • Guide de déploiement et transfert

Le périmètre dépend des formats, droits sur les données, systèmes existants et critères d’acceptation.

Parlons de votre base de connaissances

PRODUIT RÉCENT / WENQU EQ-AGENT

WenquEQ-AGENT

Un agent pour la création de sujets d’examen.

Un produit récent, exécuté localement, qui relie lecture des sources, génération de questions, révision et archivage. Il intègre un cœur d’agent open source à un processus spécialisé.

  1. 01Comprendre
  2. 02Lire les sources
  3. 03Générer
  4. 04Vérifier et réviser
  5. 05Archiver
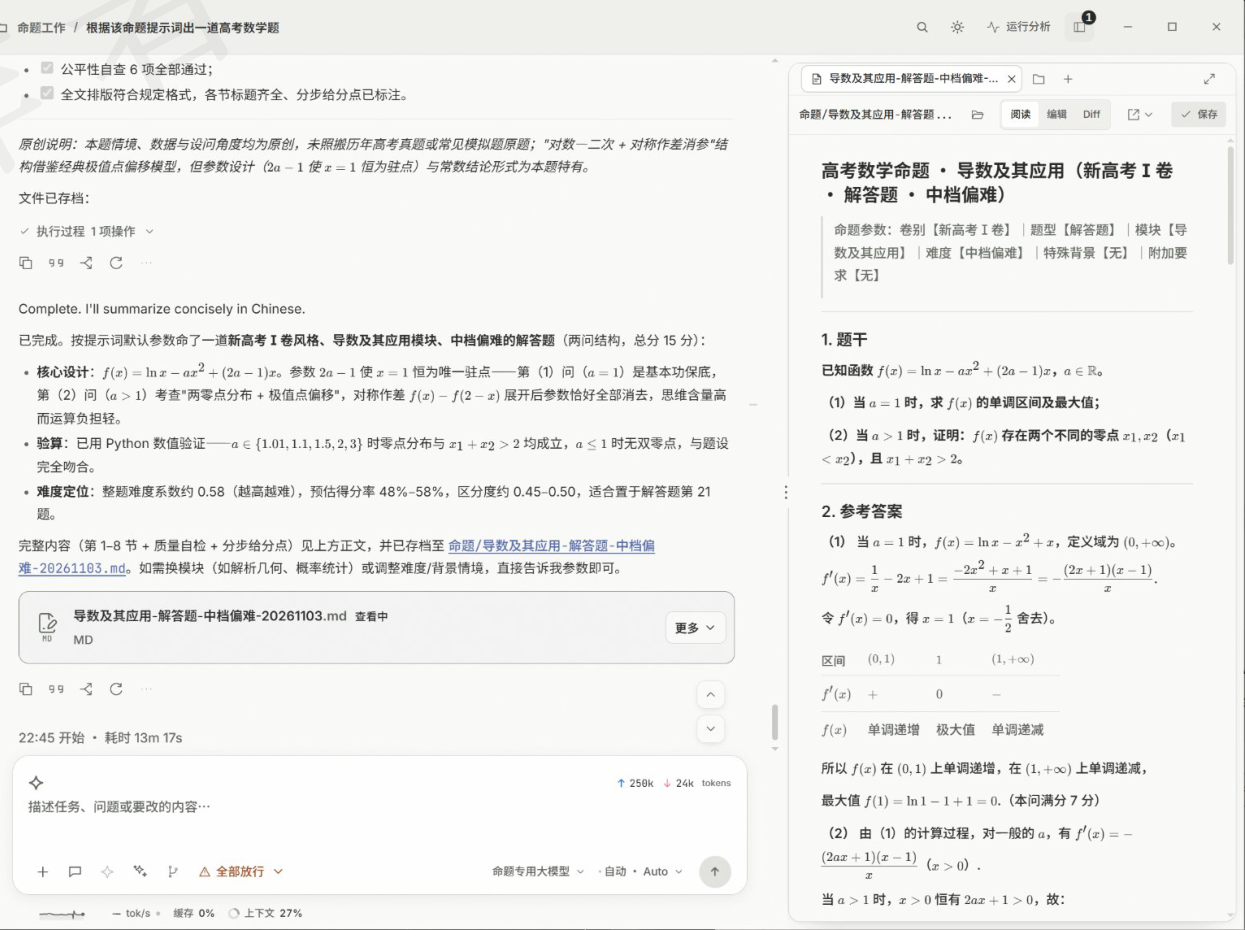
Espace de travail Wenqu : création de questions de mathématiques, autovérification et sortie Markdown.
Extrait de l’interface présenté dans la documentation du produit.

ASPECTS TECHNIQUES

01

Outils et coordination multi-agents

Opérations sur les fichiers et vérifications, avec planification et exécution coordonnées.

02

Skills réutilisables

Procédures expertes, critères de qualité et listes de contrôle structurés et réutilisables.

03

Contexte, droits et audit

Gestion des tâches longues, permissions limitées, approbations et traces d’exécution.

04

Exécution locale et modèles internes

Processus exécutés dans une application locale reliée aux modèles du réseau interne.

Cet exemple présente la génération de questions de mathématiques de niveau lycée, leur vérification et leur archivage en Markdown.

02 / ENGINEERING CAPABILITIES

Les systèmes
autour de votre agent.

Définissons le périmètre et l’approche technique selon vos objectifs et votre environnement existant.

01

RAG et bases de connaissances

Exemple de processus
  1. Collecter les sources métier
  2. Chercher et reclasser
  3. Répondre avec citations

Renvoyer au passage et à la version de la source pour vérification.

Construire des connaissances consultables, traçables et maintenables à partir de règles internes, de documentation produit et technique, reliées à votre activité.

Périmètre
Collecte des sources, analyse et découpage, recherche vectorielle et par mots-clés, reclassement et citations ; graphes de connaissances si nécessaire.
Intégration
API de questions-réponses, interfaces de recherche interne ou outils d’agent, avec espaces organisés selon les droits des services et des clients.
Livraison et validation
Vérifier recherche et réponses avec des questions représentatives. Livrer les traitements d’indexation, API, évaluations et consignes de maintenance.
  • Recherche documentaire
  • Intégration métier
  • Évaluation des réponses
02

OCR et traitement documentaire

Exemple de processus
  1. Scans et PDF
  2. Extraire et vérifier
  3. Stocker les données

Confier les champs peu fiables à un réviseur.

Transformer images, scans et PDF en données métier, en reliant la révision humaine aux systèmes en aval pour réduire les ressaisies.

Périmètre
OCR, analyse des mises en page et tableaux, extraction de champs, normalisation et vérification des règles métier.
Traitement
Entrées par lots ou API, signalement des champs peu fiables et, selon les besoins, validation humaine, gestion des exceptions et suivi des traitements.
Livraison et validation
Résultats structurés, API et correspondances de champs, évalués sur vos échantillons pour la précision et la durée du traitement.
  • Texte et champs
  • Données structurées
  • Intégration système
03

Inférence et déploiement de modèles

Exemple de processus
  1. Connecter les modèles
  2. Déployer l’inférence
  3. Servir les applications

Vérifier latence, débit et coût des ressources sous la charge convenue.

Concevoir l’inférence selon les modèles, les contraintes de données et la concurrence. Vérifier performances, stabilité et coûts avec le matériel et le budget disponibles.

Périmètre
Déploiement local ou privé, connexion aux modèles, API unifiées et authentification.
Optimisation
Étudier quantification, lots, cache et routage selon les besoins. Mesurer latence, débit, ressources et erreurs.
Livraison et validation
Configurations, comparaison des performances et coûts, surveillance, mises à jour et retour arrière, testés à une charge convenue.
  • Infrastructure d’inférence
  • Validation des performances
  • Déploiement
04

Développement full-stack et données

Exemple de processus
  1. Espace Web
  2. API et processus
  3. Données et intégrations

Vérifier les accès et les régressions sur l’interface, les API et les flux de données.

Intégrer les modèles aux outils utilisés au quotidien, du frontend au backend, avec traitement des données et tests.

Applications
Espaces Web, administration, API, rôles et processus connectés aux systèmes existants et aux services tiers.
Données
Collecte, nettoyage, transformation, tâches planifiées et contrôles de qualité au service des analyses et applications métier.
Qualité et transfert
Tests fonctionnels, d’API et d’intégration ; code source, documentation des API, déploiement et transfert d’exploitation.
  • Développement full-stack
  • Pipelines de données
  • Tests et qualité

Accompagnement par étape de projet

Pour les collaborations avec le Japon et les systèmes existants, convenir du périmètre, des livrables et de la recette client à chaque étape.

Besoins et conception de la recette

Décrire les processus métier, les limites du système et les exceptions. Confirmer les spécifications, les changements et les critères de recette dans des documents en japonais.

Exemples de livrables
Besoins, interfaces, registre des changements et cas de recette.

Intégration et migration progressive

Recenser les dépendances et structures de données, connecter les systèmes par API ou traitements par lots, et préparer les contrôles et répétitions de bascule.

Exemples de livrables
Inventaire des dépendances, correspondance des champs et procédures de bascule et de retour arrière.

Tests automatisés et transfert de mise en production

Préparer les tests d’API et de régression prévus, puis intégrer les contrôles essentiels à la CI. Organiser le transfert des accès, journaux d’audit, mises en production et alertes.

Exemples de livrables
Résultats des tests, liste de vérification de mise en production et guide de transfert à l’exploitation.

03 / THE TEAM

Des expertises fortes.
Une équipe unie.

Une capacité stable de 20 personnes. Nous réunissons les profils adaptés au périmètre et à la phase de votre projet.

L’équipe comprend des ingénieurs ayant travaillé au centre d’intelligence artificielle d’Alibaba DAMO Academy.

20pers.

INGÉNIERIE ET QUALITÉ

10pers.

Développement full-stack

Web · API · Intégration

5pers.

IA et algorithmes

Modèles · Recherche · Inférence

2pers.

Ingénierie des données

Traitements · Pipelines

3pers.

Tests et qualité

Tests fonctionnels · Vérifications

04 / WORKING TOGETHER

La collaboration adaptée à votre projet.

Adapter l’engagement au périmètre, aux compétences et au calendrier.

À l’écrit en japonais, en réunion en anglais.

Aligner les besoins et décisions par écrit, et mener les échanges techniques en anglais.

JAPANESE / ENGLISH

05 / FROM BRIEF TO DELIVERY

Un parcours clair jusqu’au transfert.

  1. 01

    Comprendre le besoin

    Préciser processus, difficultés, priorités et environnement existant.

  2. 02

    Définir périmètre et équipe

    Convenir des livrables, responsabilités, jalons et vérifications.

  3. 03

    Développer et valider

    Partager l’avancement et développer par étapes avec des tests continus.

  4. 04

    Livrer et transférer

    Vérifier les résultats convenus et transmettre les éléments nécessaires à l’exploitation.

LET’S BUILD SOMETHING USEFUL

Parlons de
votre projet.

Vos besoins, votre calendrier et les profils recherchés. Partons de ce que vous savez déjà.

Nous écrire

Le bouton ouvre votre application de messagerie.

Société
杭州云眼数据科技有限公司
Localisation
Hangzhou, Zhejiang, Chine